1억 건의 대용량 데이터 insert 하기
1. Spring Data JPA saveAll() 여러 개의 데이터를 insert하는 방법 중 가장 먼저 떠오르는 방법이다. 쉽고 간단하게 데이터 insert가 가능하다. 위 코드에서 100만개의 데이터를 생성하여 saveAll메서드를 통해 일괄 저장하는 테스트를 작성하였다. 실행 결과, 1분 22초의 시간이 걸렸다. 비교적 작은 크기의 엔티티...
1. Spring Data JPA saveAll()
여러 개의 데이터를 insert하는 방법 중 가장 먼저 떠오르는 방법이다.
쉽고 간단하게 데이터 insert가 가능하다.
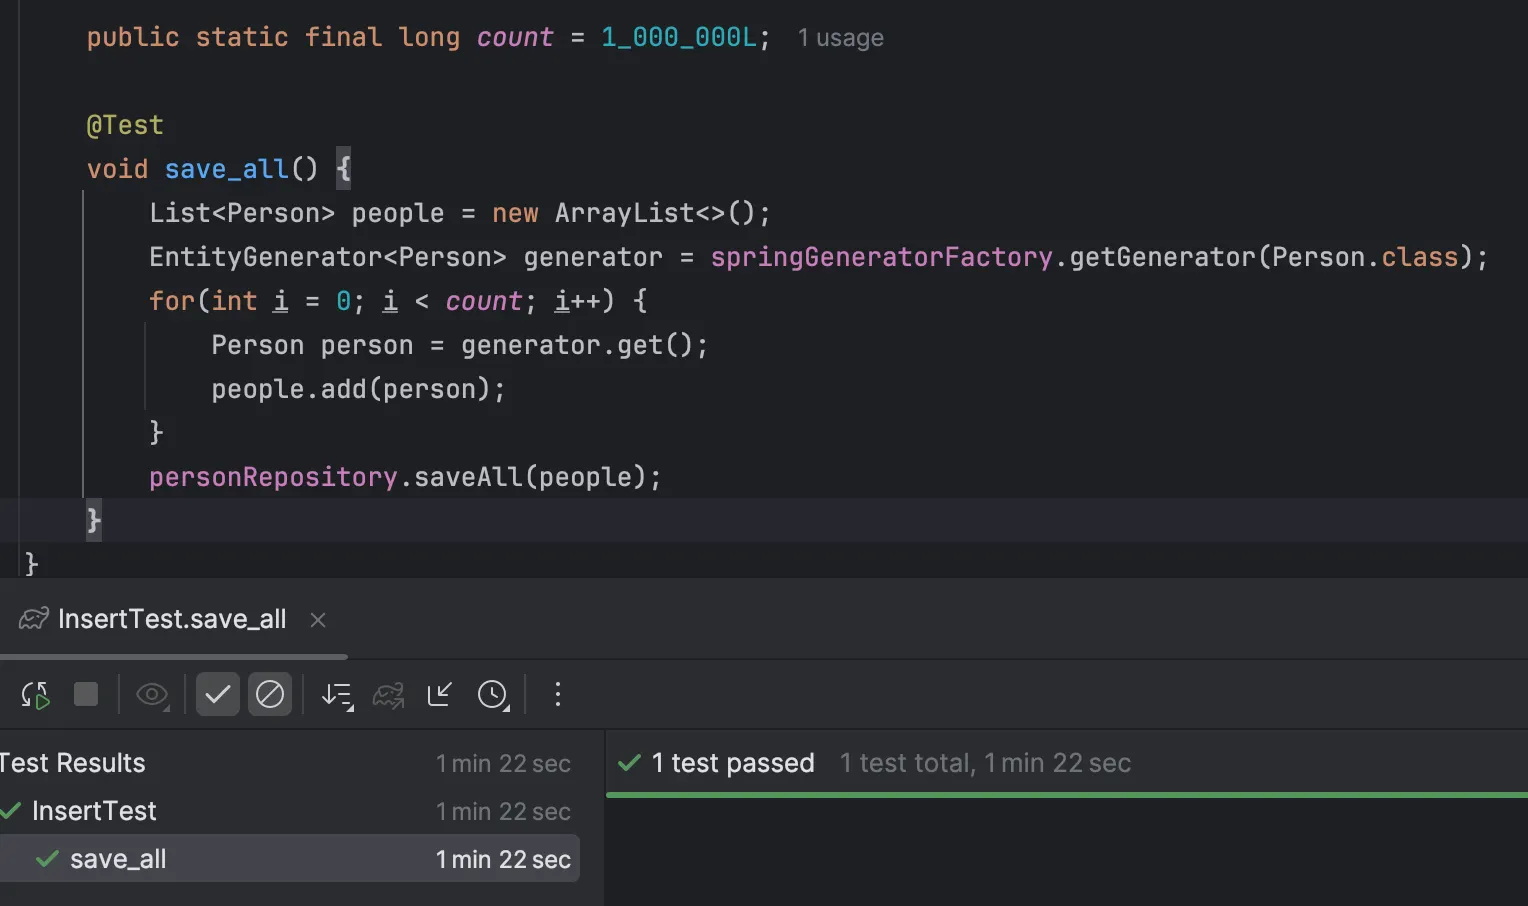
위 코드에서 100만개의 데이터를 생성하여 saveAll메서드를 통해 일괄 저장하는 테스트를 작성하였다.
실행 결과, 1분 22초의 시간이 걸렸다. 비교적 작은 크기의 엔티티라 빠르게 저장되는 듯 했다.
하지만 hibernate의 saveAll방식은 각 레코드를 단건으로 저장한다. 즉, 저장하려는 데이터의 수 만큼 쿼리가 발생하는 것이다.
이는 10만 이상의 대용량 데이터를 삽입하는 로직에서는 적절하지 않다.
물론 hibernate.jdbc.batch_size를 설정하여 배치 사이즈 만큼 쿼리를 배치 실행할 수 있지만, 이와 다른 방법을 알아보고자 한다.
2. JDBC
JDBC는 자바의 가장 기본적인 DB 접근 API이다.
저수준의 API로서, 빠른 성능을 보여주는 특징이 있다.
jdbcTemplate의 batchUpdate메서드를 통해 대용량의 데이터를 저장할 수 있다.
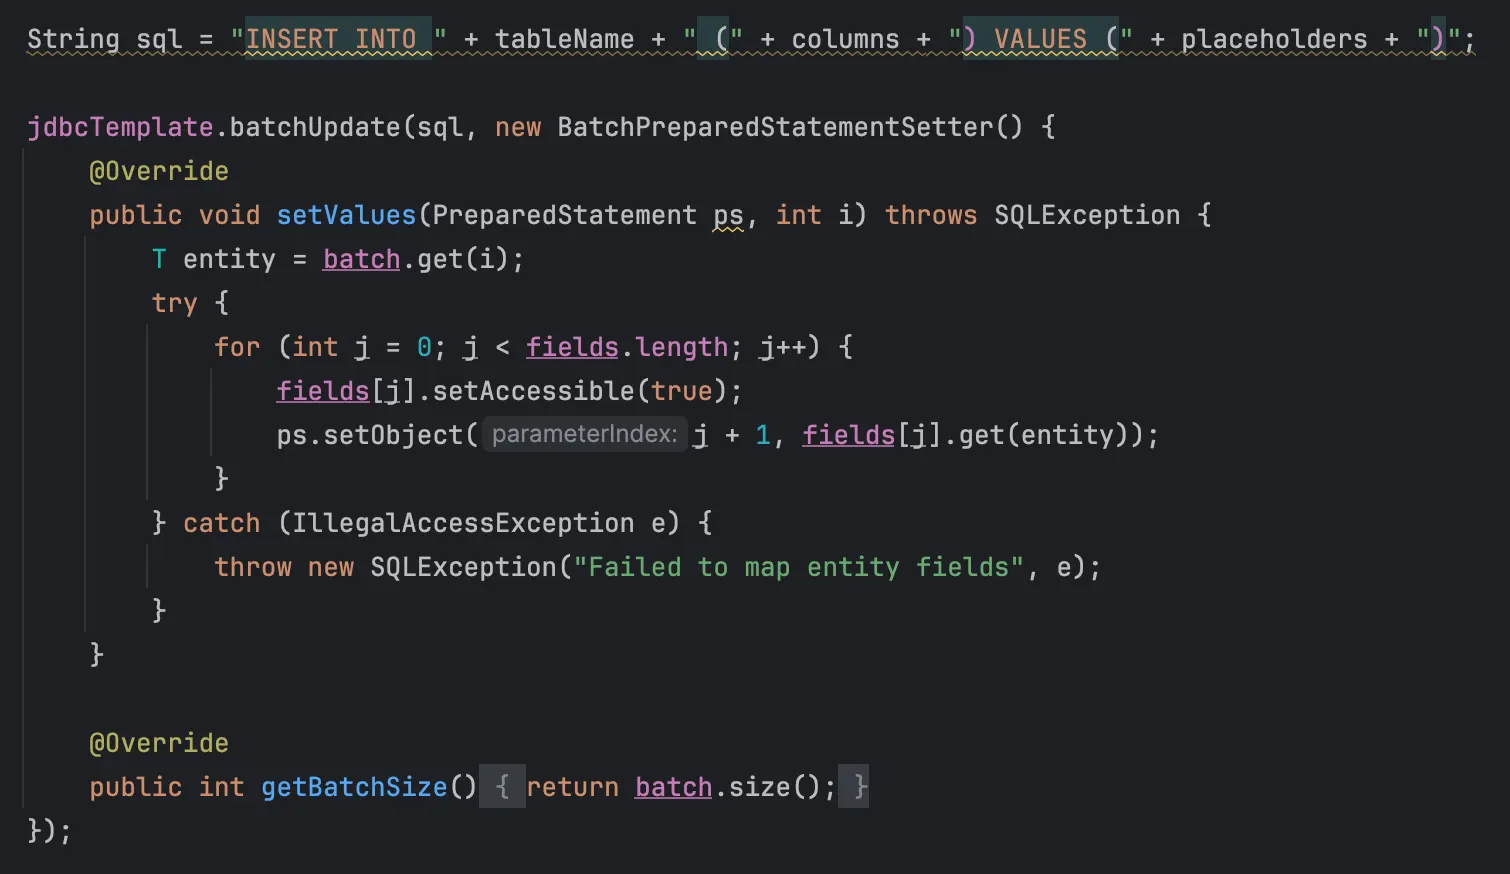
BatchPreparedStatementSetter를 구현함으로써 사용이 가능해진다.
sql을 직접 작성하여 쿼리를 보내므로 hibernate의 saveAll방식보다 빠른 성능을 보일 것이라고 예상했다.
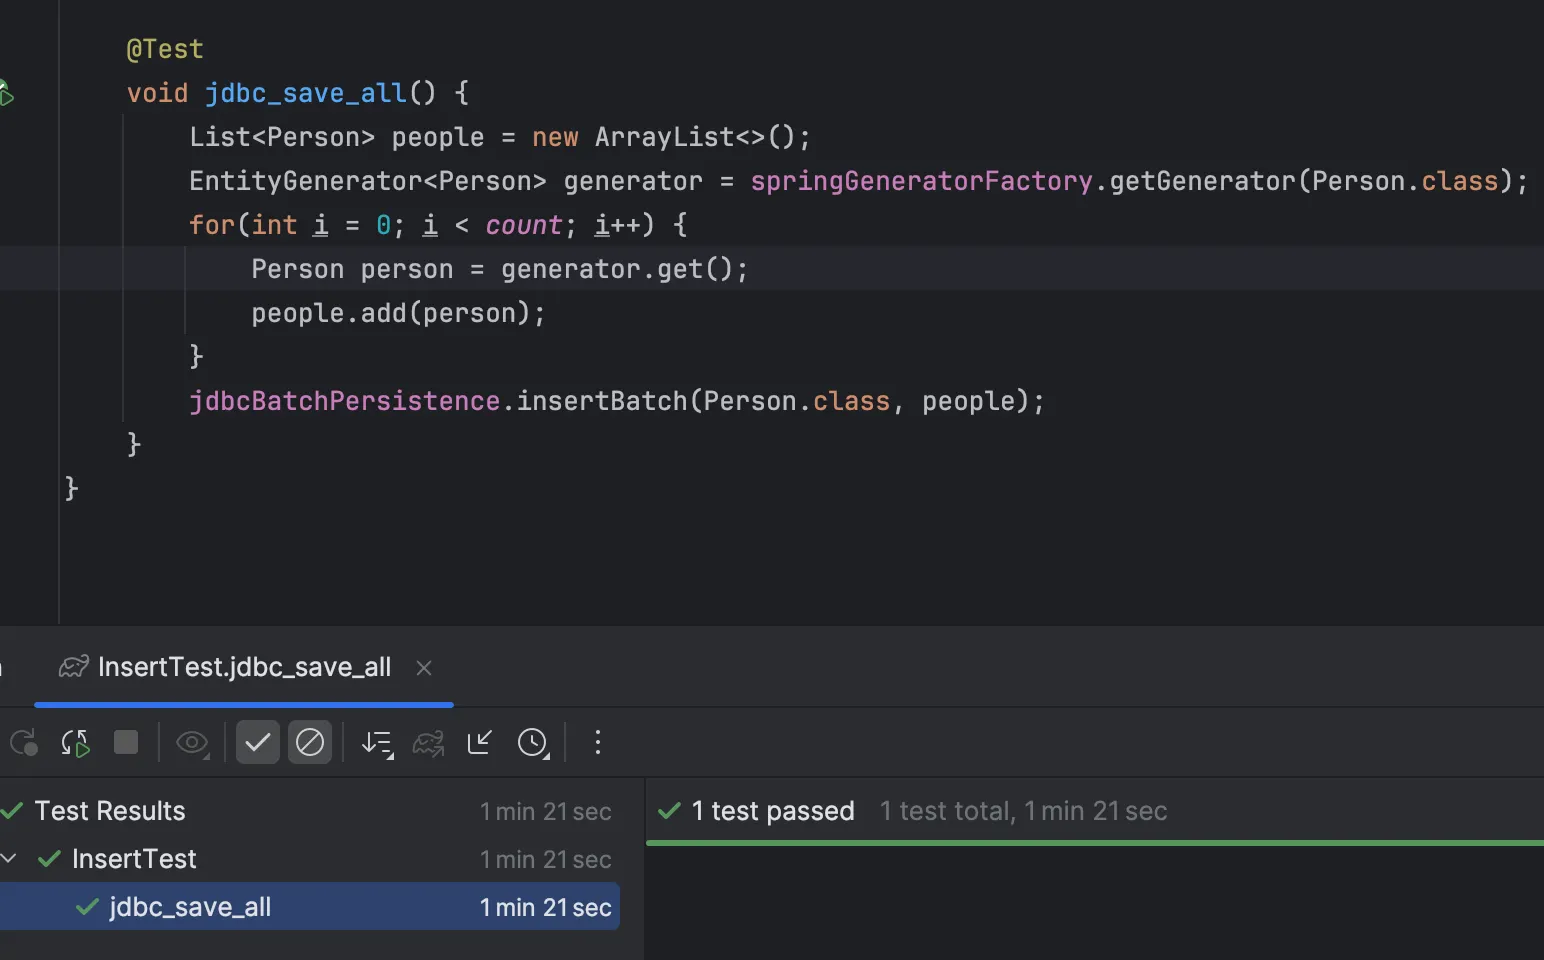
하지만 100만 개의 데이터에 대해 1분 21초로 saveAll과 별반 다르지 않은 결과를 보여주었다.
이유는 해당 로직 또한 각 데이터마다 쿼리를 보내는 단건 쿼리이기 때문이다. 즉, saveAll과 쿼리 개수는 동일하다.
jdbc에서 배치 처리를 위해서는 rewriteBatchedStatements=true값을 추가해야한다.
1
2
3
4
spring:
  datasource:
    url: jdbc:mysql://localhost:3306/test?rewriteBatchedStatements=true
    username: root
해당 파라미터 설정 후, 실행 결과는 다음과 같다.
1분 20초에서 4.2초로 약 95% 성능 향상을 볼 수 있었다.
허면 어느 정도의 대용량까지 가능한걸까? 확인해보자
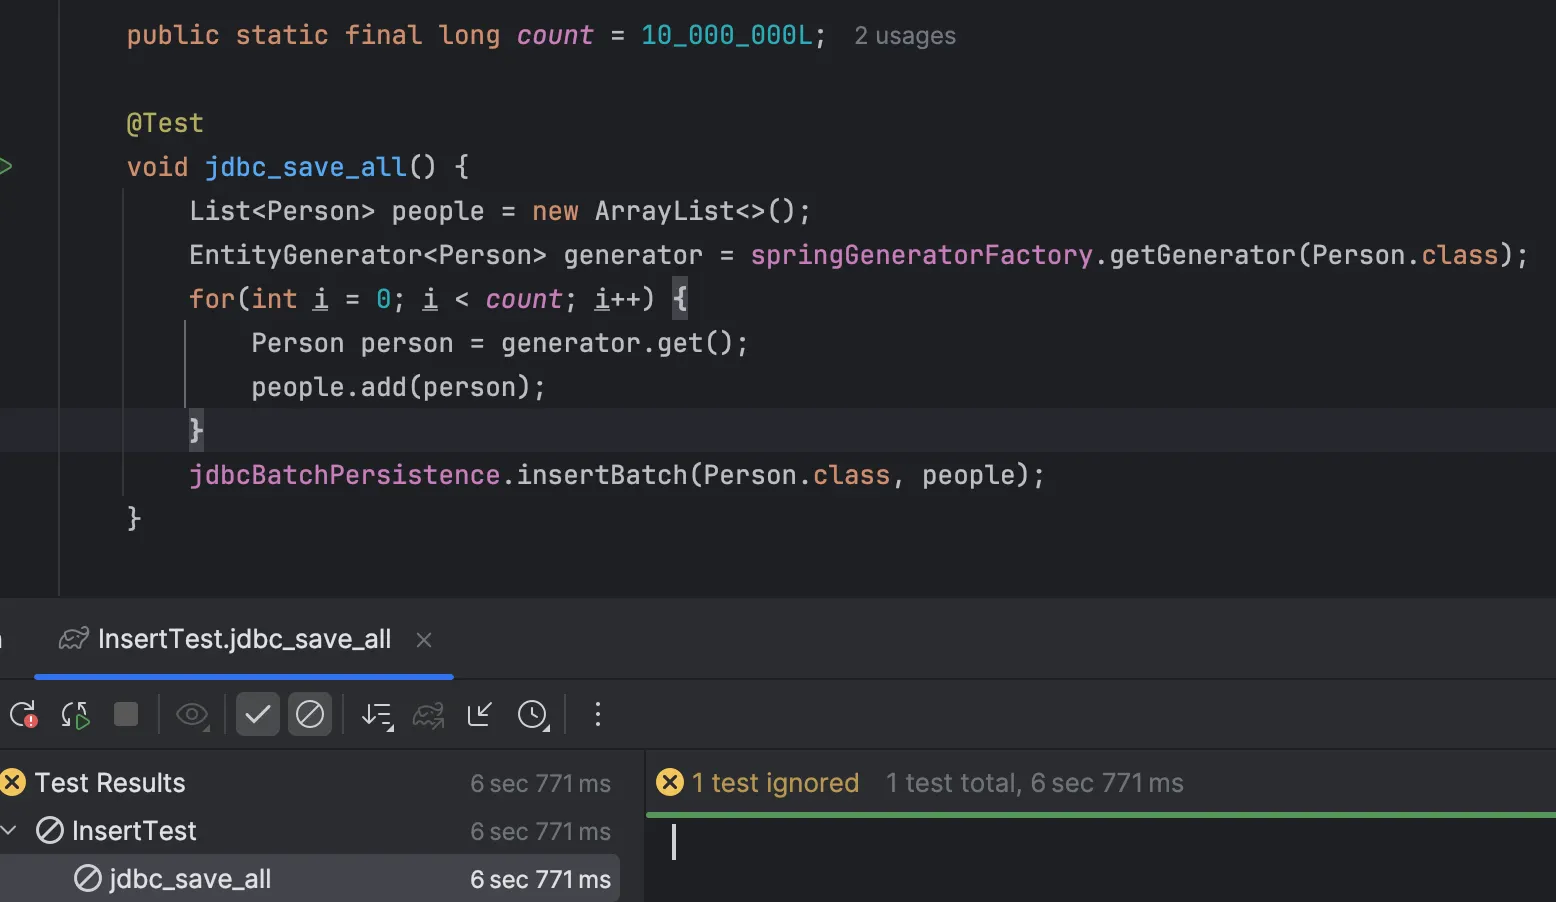
천만 건의 데이터를 저장하려했지만 ignored 되었다.
List 자료구조에 천만 개의 인스턴스를 삽입하는 과정에서 jvm 힙 메모리에 과부하가 걸린 듯 했다.
쿼리 속도의 향상은 이루었지만, 대용량의 데이터를 담을 메모리의 크기도 고려해야하는 문제이다.
대용량의 데이터를 insert하기 위해 메모리 크기를 늘리는 것이 능사는 아닐 것이다. 더 효율적인 방법을 찾고자 했다.
첫 번째 아이디어 : 배치 연산
힙 메모리가 감당할 수 없을 만큼의 데이터를 insert하고자 한다면, 감당할 수 있는 만큼 데이터를 생성하고 insert한 후, 새로운 리스트로 초기화하여 메모리의 부담을 줄일 수 있다.
하지만 위 방식은 데이터가 늘어남에 따라 걸리는 시간도 정비례하여 증가한다는 문제가 있을 것으로 예상했다.
두 번째 아이디어 : 멀티 스레드
동시에 여러 스레드가 데이터를 생성해서 insert한다면 스레드의 수 만큼 데이터 삽입이 빨라질 것이다.
배치 연산과 멀티 스레드를 합쳐 데이터 insert을 진행한다면, 단순히 멀티 스레드만 사용하는 것 보다 더 빠르고 많은 양의 데이터를 삽입할 수 있을 것이라고 생각했다.
이에 다음과 같이 구현 계획을 작성하였다.
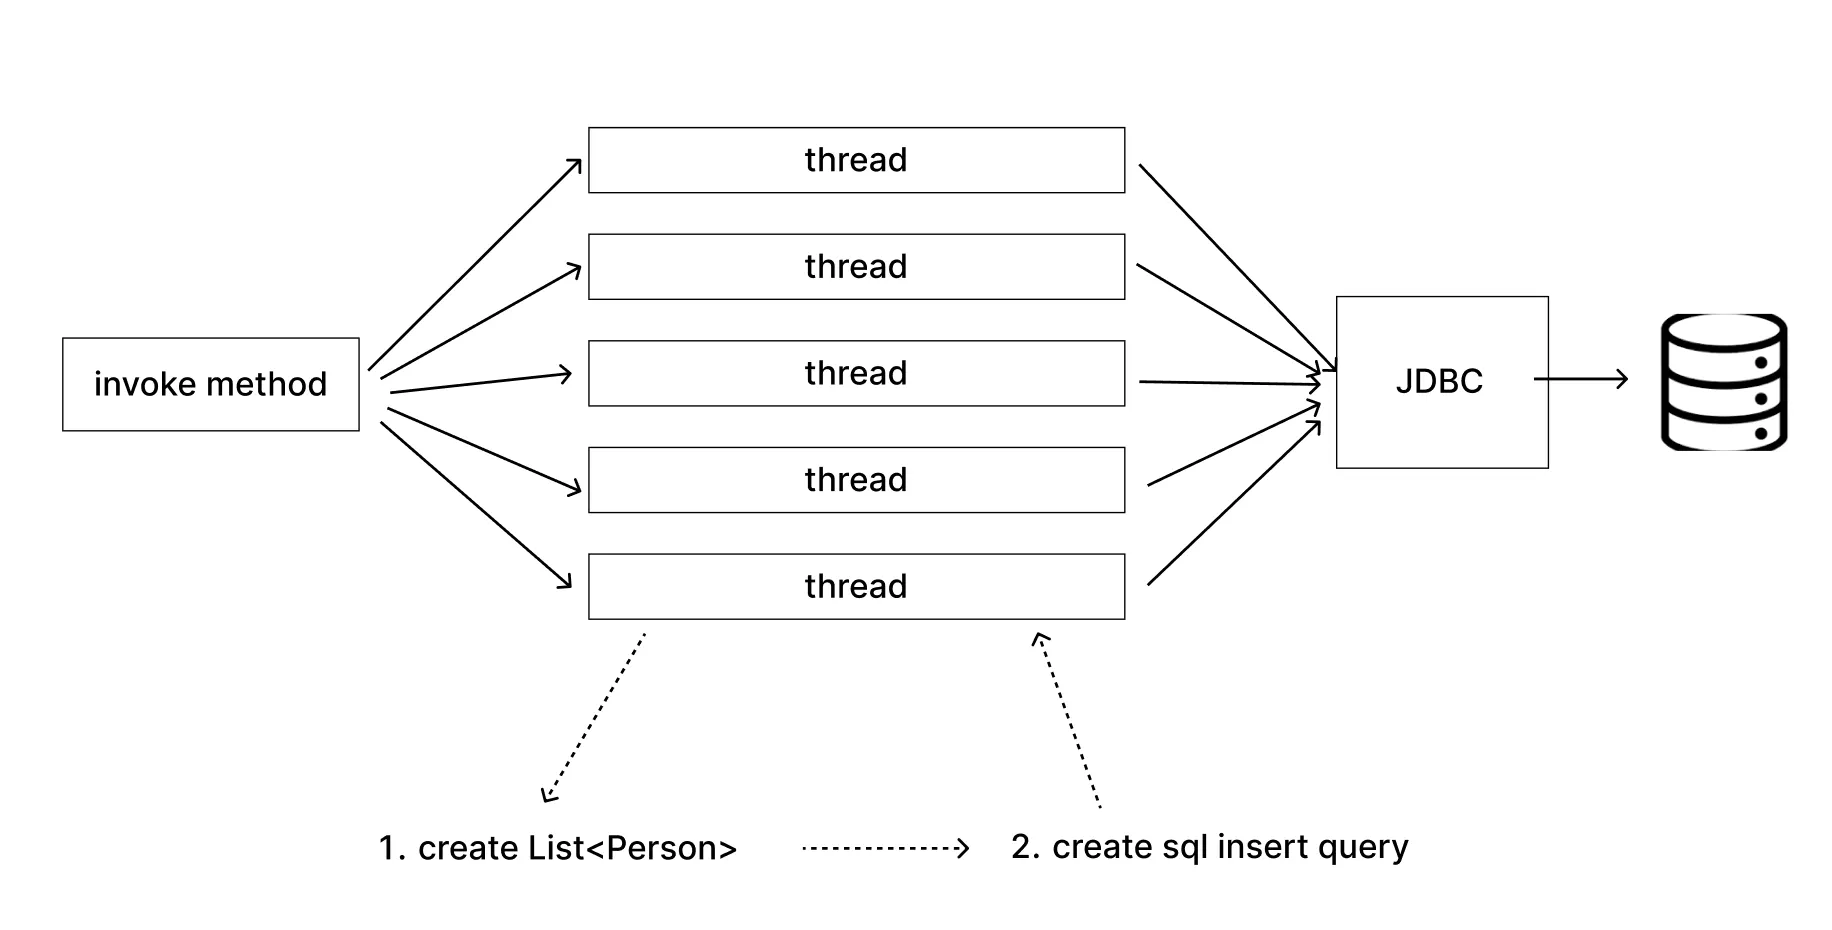
힙 메모리가 감당할 수 있을 만큼 인스턴스를 생성하여 스레드풀에서 동시에 db에 저장하는 이 로직은 문제 없을 것이라고 생각했다.
하지만 하나의 스레드가 인스턴스 생성 + db 저장까지 하게 되는 과정에서 db I/O가 발생하는 동안은 CPU는 대기 상태가 되어 해당 시간동안은 인스턴스 생성이 되지 않는다는 것을 깨달았다.
이를 해결하기 위해 인스턴스 생성과 DB 저장을 역할별로 분리하여 병렬 처리하는 구조(생산자·소비자 구조)를 구상했다.
세 번째 아이디어 : 생산자 · 소비자 구조
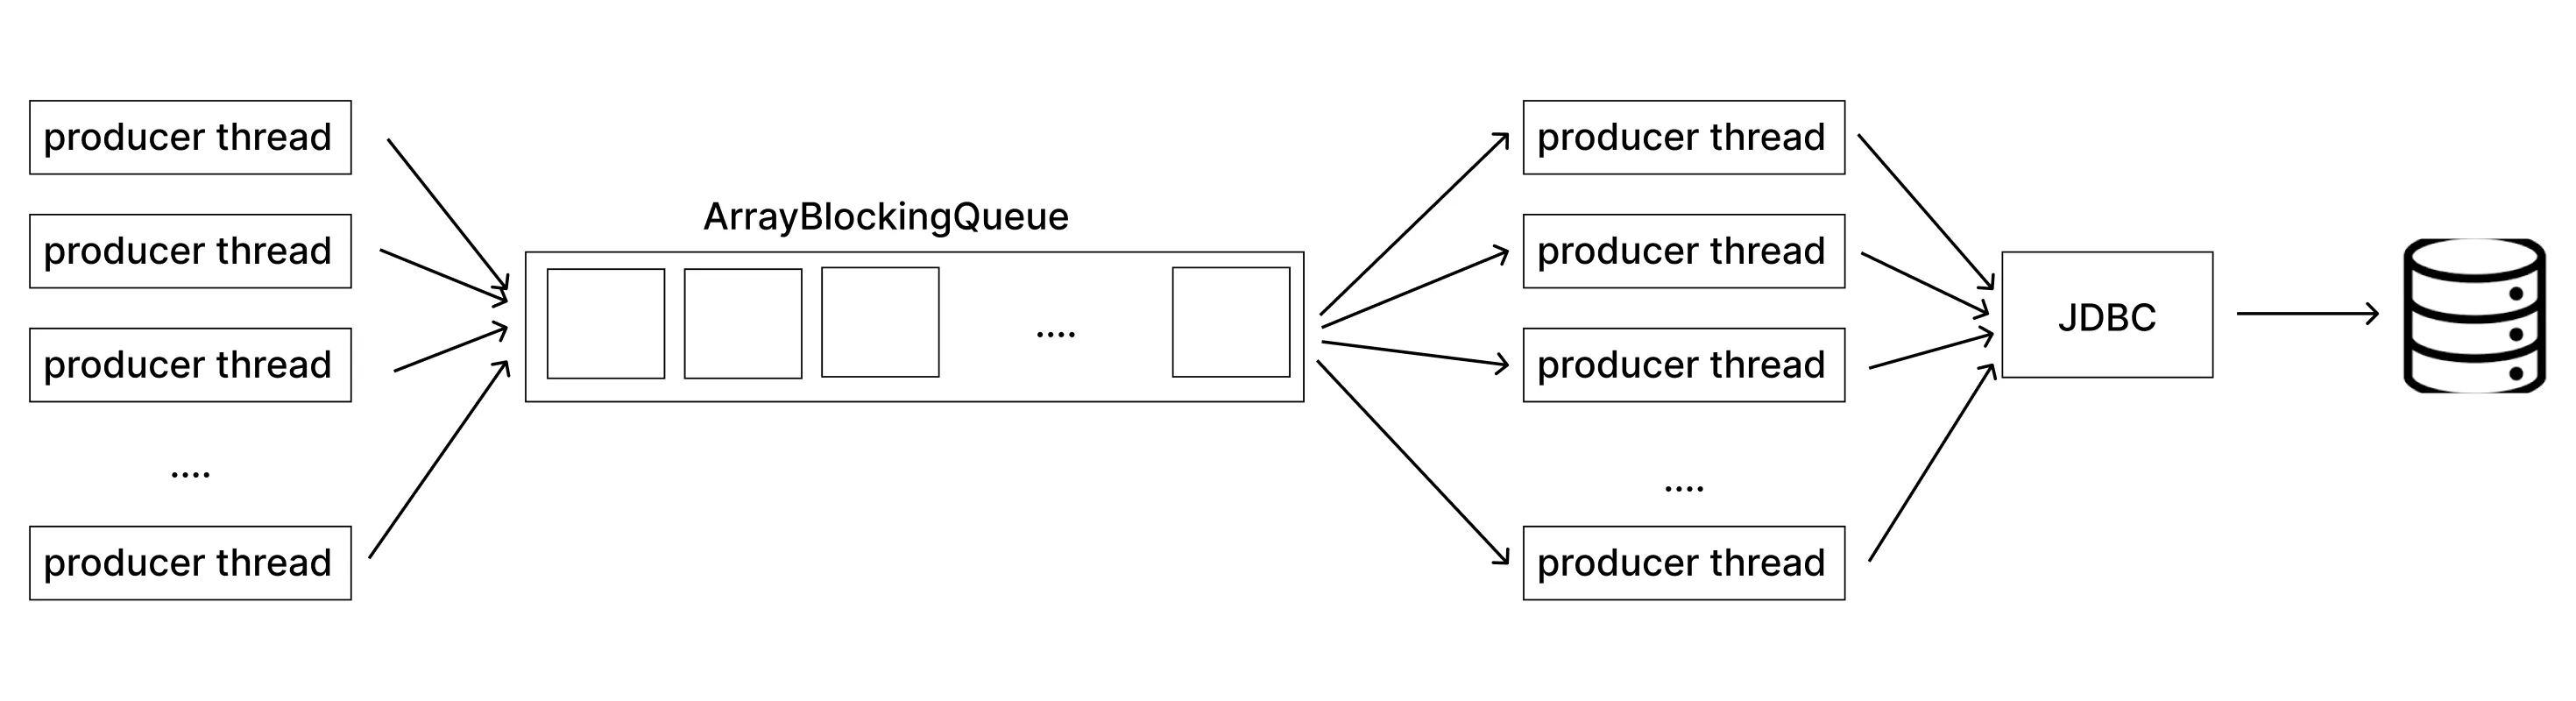
생산자 스레드 풀은 사용자가 설정한 batch_size만큼 엔티티 인스턴스를 생성한다. 작업이 완료되면 큐에 해당 작업을 push한다.
소비자 스레드 풀은 큐에서 작업을 꺼내 sql에 저장한다. I/O 연산 중심 스레드이기에 커넥션 풀의 크기와 동일하거나 작게 스레드를 유지한다.
이때 중요한 것은 큐의 크기이다. 큐가 무한정으로 커질 수 있다면 생산자 스레드는 끊임없이 큐에 작업을 넣어 힙 메모리의 과부화를 불러일으킬 수 있다.
즉, 큐의 크기를 설정하여 큐가 꽉 찼을 시 생산자 스레드는 대기하고 소비자 스레드가 해당 큐의 작업을 소비할 수 있도록 기다릴 필요가 있다.
큐는 크기를 정할 수 있고 멀티 스레딩 환경에서도 안전한ArrayBlockingQueue를 사용할 수 있다.
이를 다이어그램으로 작성해 보았다.
먼저, 생산자·소비자 스레드풀을 정의하였다.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
@Configuration
public class BulkExecutorDefaultConfiguration {

    @Bean
    @ConditionalOnMissingBean(name = "bulkProducerExecutor")
    public ThreadPoolTaskExecutor bulkProducerExecutor() {
        return new ThreadPoolTaskExecutorBuilder()
                .corePoolSize(16)
                .maxPoolSize(16)
                .queueCapacity(10000)
                .threadNamePrefix("Bulk-Producer-").build();
    }

    @Bean
    @ConditionalOnMissingBean(name = "bulkConsumerExecutor")
    public ThreadPoolTaskExecutor bulkConsumerExecutor() {
        return new ThreadPoolTaskExecutorBuilder()
                .corePoolSize(16)
                .maxPoolSize(24)
                .queueCapacity(0)
                .threadNamePrefix("Bulk-Consumer")
                .build();
    }
}
@ConditionOnMissingBean을 통해 빈을 새로 정의할 수 있도록 하였다.
또한 ConsumerExecutor에서 큐 사이즈를 0으로 만듦으로써 직접 ArrayBlockingQueue를 사용하고자 했다.
아래 코드는 설정한 스레드풀을 이용한 생산자·소비자 구조 구현 코드이다.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
@Component
public class BulkPersistenceManager<T> {

    private final ThreadPoolTaskExecutor producerExecutor;
    private final ThreadPoolTaskExecutor consumerExecutor;
    private final JdbcBatchPersistence jdbcBatchPersistence;
    private final BlockingQueue<List<T>> queue = new ArrayBlockingQueue<>(48);

    public BulkPersistenceManager(ThreadPoolTaskExecutor bulkProducerExecutor, ThreadPoolTaskExecutor bulkConsumerExecutor, JdbcBatchPersistence jdbcBatchPersistence) {
        this.producerExecutor = bulkProducerExecutor;
        this.consumerExecutor = bulkConsumerExecutor;
        this.jdbcBatchPersistence = jdbcBatchPersistence;
    }

    public void start(EntityGenerator<T> generator, long totalCount, Class<T> entityType) throws InterruptedException {
        int batchSize = 10000;
        int consumerThreads = consumerExecutor.getCorePoolSize();

        CountDownLatch producerLatch = new CountDownLatch((int) Math.ceil((double) totalCount / batchSize));
        CountDownLatch consumerLatch = new CountDownLatch(consumerThreads);

        // 소비자 스레드 시작
        for (int i = 0; i < consumerThreads; i++) {
            consumerExecutor.execute(() -> {
                try {
                    while (true) {
                        List<T> batch = queue.take();
                        if (batch.isEmpty()) break; // 빈 리스트를 받으면 -> finally
                        jdbcBatchPersistence.insertBatch(entityType, batch);
                        System.out.printf("[Consumer][%s] Inserted batch size=%d%n",
                                Thread.currentThread().getName(), batch.size());
                    }
                } catch (InterruptedException e) {
                    Thread.currentThread().interrupt();
                } finally {
                    consumerLatch.countDown();
                }
            });
        }

        // 생산자 스레드 시작
        for (long i = 0; i < totalCount; i += batchSize) {
            producerExecutor.execute(() -> {
                List<T> batch = new ArrayList<>(batchSize);
                for (int j = 0; j < batchSize; j++) {
                    batch.add(generator.get());
                }
                try {
                    queue.put(batch);
                    System.out.printf("[Producer][%s] Produced batch size=%d%n",
                            Thread.currentThread().getName(), batch.size());
                } catch (InterruptedException e) {
                    Thread.currentThread().interrupt();
                } finally {
                    producerLatch.countDown();
                }
            });
        }

        // 모든 생성자 스레드 종료까지 메인 스레드는 대기
        producerLatch.await();

        // 소비자 스레드에게 생성이 종료되었음을 전달
        for (int i = 0; i < consumerThreads; i++) {
            queue.put(Collections.emptyList());
        }

        // 모든 소비자 스레드 종료까지 메인 스레드는 대기
        consumerLatch.await();

        shutdownExecutors();
    }

    private void shutdownExecutors() {
        producerExecutor.shutdown();
        consumerExecutor.shutdown();
    }
}
- 소비자 스레드풀은 스레드 수 만큼 스레드를 실행시킨다.
- 이때
while(true)를 통해 큐에서 작업을 가져와 db에 저장을 진행한다. - 만약 작업이 비어있으면, 해당 스레드는 종료된다. (consumerLatch += 1)
- 이때
- 생산자 스레드풀은 totalSize와 batchSize를 통해 인스턴스 생성을 진행한다.
- batchSize만큼 인스턴스를 만들어 큐로
put연산을 진행한다. (producerLatch += 1)
- batchSize만큼 인스턴스를 만들어 큐로
- 이때 소비자 스레드와 생산자 스레드는 동시에 실행된다.
- 메인 스레드는
producerLatch의 값이 Math.ceil((double) totalCount / batchSize)가 될 때까지 대기한다. (Math.ceil((double) totalCount / batchSize) : insert하고자하는 인스턴스 개수와 배치 사이즈를 통해 수행되어야하는 작업의 수) - 생산자 스레드풀에서 모든 인스턴스를 생성하고 큐로
put했다면, 소비자 스레드풀에게 작업이 완료되었음을 알리기 위해 소비자 스레드 개수 만큼 빈 리스트를 큐로 보낸다. - 이때 메인 스레드는
consumerLatch.await()에서 모든 소비자 스레드가 작업을 종료할 때까지 대기한다. - 소비자 스레드는 해당 빈 리스트를 받으면 모든 작업이 끝났음을 확인하고 countDown()을 호출하여 작업을 마무리 한다.
- 모든 소비자 스레드가 countDown()을 호출하고 작업을 마무리햇을 때, 메인 스레드는 대기를 멈추고 다음 코드로 진행한다.
이렇게 하여 힙 메모리를 넘치게 하지 않으면서 스레드풀을 사용하여 대규모 데이터를 insert하는 로직을 구현하였다.
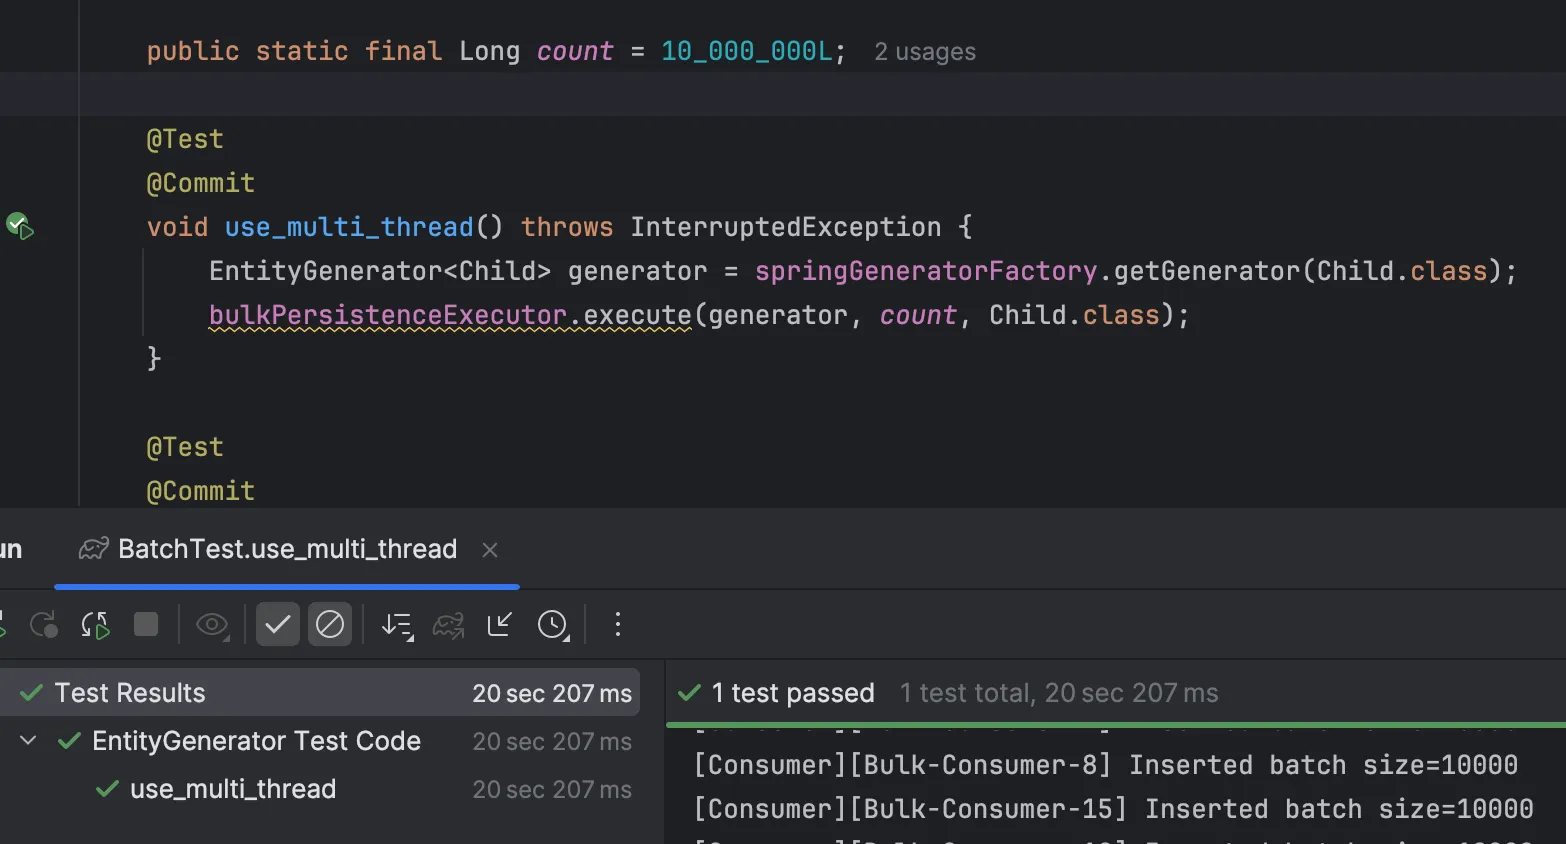
천만 건의 데이터에 대해 Out of Memory 에러 없이 20초만에 데이터 insert됨을 확인할 수 있었다.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
[Consumer][Bulk-Consumer-9] Inserted batch size=10000
[Producer][Bulk-Producer-2] Produced batch size=10000
[Consumer][Bulk-Consumer-5] Inserted batch size=10000
[Producer][Bulk-Producer-6] Produced batch size=10000
[Consumer][Bulk-Consumer-7] Inserted batch size=10000
[Producer][Bulk-Producer-9] Produced batch size=10000
[Consumer][Bulk-Consumer-13] Inserted batch size=10000
[Producer][Bulk-Producer-7] Produced batch size=10000
[Consumer][Bulk-Consumer-1] Inserted batch size=10000
[Producer][Bulk-Producer-5] Produced batch size=10000
[Consumer][Bulk-Consumer-4] Inserted batch size=10000
[Producer][Bulk-Producer-12] Produced batch size=10000
[Consumer][Bulk-Consumer-6] Inserted batch size=10000
[Producer][Bulk-Producer-4] Produced batch size=10000
[Consumer][Bulk-Consumer-3] Inserted batch size=10000
[Producer][Bulk-Producer-1] Produced batch size=10000
[Consumer][Bulk-Consumer-16] Inserted batch size=10000
[Producer][Bulk-Producer-15] Produced batch size=10000
또한, 배치 사이즈(1만)만큼 생산자와 소비자가 동시에 데이터를 생성하고 저장되는 과정도 로그를 통해 확인하였다.
나아가 1억 건의 데이터에 대해 insert를 진행해보자.
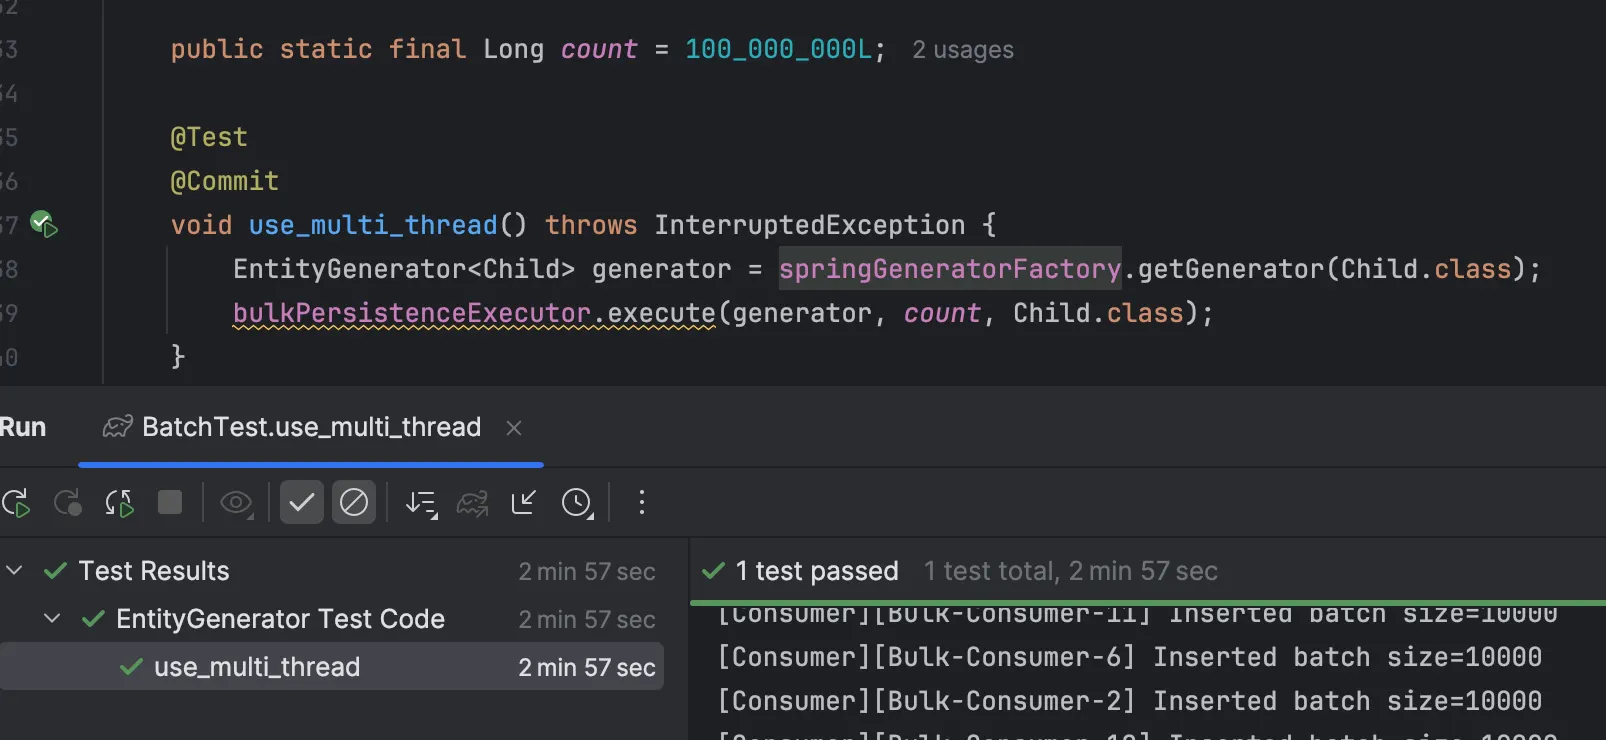
대략 3분(=180초) 정도의 시간이 걸렸다. 천만 건의 데이터를 저장하는데 20초가 걸린 것을 고려했을 때, 저장하려는 데이터가 증가함에 따라 걸리는 시간도 비례하여 증가할 것이라는 예상과 맞아 떨어졌다.
1억 건에 대해 3분이면 빠르게 저장된게 아닐까? 라는 생각이 들었다.
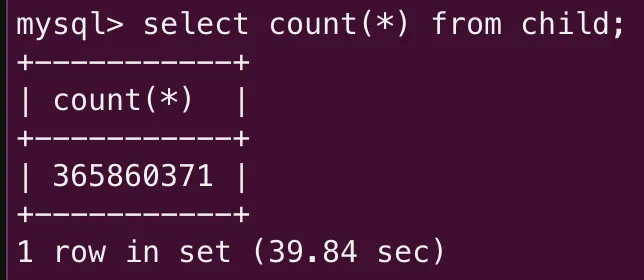
해당 테스트를 3번 실행하여 count 조회로 총 3억 6천만 개의 레코드를 확인하였다. (데이터 개수 조회를 하는데 무려 39초나 걸렸다.. 여기에 인덱스를 생성하면 어떨까?)
여기서 생산자·소비자 스레드 풀에서의 스레드 개수, spring 애플리케이션의 max_connection 개수, batch_size, 엔티티의 크기 등 다양한 인자들이 쿼리 시간에 영향을 줄 것이다. 최적화를 잘 진행하면 이보다 더 빠른 경우도 존재할 것이다.
생산자 스레드의 개수를 증가시키면 인스턴스를 생산하는 CPU 사용량이 증가할 것이고,
소비자 스레드의 개수를 증가시키고 커넥션 풀이 확보되지 않으면 오히려 커넥션 풀 대기로 인해 처리 속도가 저하되는 문제가 발생할 수도 있다.
배치 사이즈를 크게 설정하면 인스턴스의 개수가 많아져 메모리 사용량이 증가할 수 있으며, 배치 사이즈를 너무 작게 설정하면 insert횟수가 많아지는 문제가 발생한다.
현재 엔티티의 크기가 작아 저장하는데 오랜 시간이 걸리지 않았지만, 스레드풀의 스레드 개수와 hikariCP의 max connection 개수, 배치 사이즈를 조정하면 현재보다 훨씬 짧은 시간 내에 더 많은 대용량 데이터를 안정적으로 삽입할 수 있을 것으로 기대된다.
현재는 연관관계가 전혀 없는 엔티티를 전제로 실험을 진행하였다. 하지만 연관관계가 존재하는 엔티티의 경우 고려해야 할 요소가 훨씬 많을 것이며, 이를 통해 더 깊은 인사이트를 얻을 수 있을 것이라 생각한다.
앞으로는 연관관계가 포함된 엔티티를 대상으로 한 대용량 insert 최적화에도 집중해볼 예정이다.
추가 수정 - 2026.01.23
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
    public <T> void start(EntityGenerator<T> generator, long totalCount, int batchSize, Class<T> entityType) throws InterruptedException {
        int consumerThreads = ((ThreadPoolExecutor) consumerExecutor).getCorePoolSize();
        CountDownLatch latch = new CountDownLatch(consumerThreads);
        long totalBatches = (long) Math.ceil((double) totalCount / batchSize);

        List<Callable<Void>> producers = new ArrayList<>();
        for (int i = 0; i < totalBatches; i++) {
            producers.add(new Producer<>(generator, queue, batchSize));
        }

        for(int i = 0; i < consumerThreads; i++) {
            consumerExecutor.execute(new Consumer<>(queue, jdbcBatchWriter, entityType, latch));
        }

        producerExecutor.invokeAll(producers);

        for (int i = 0; i < consumerThreads; i++) {
            queue.put(Collections.emptyList());
        }

        latch.await();
    }
- 위의 멀티 스레딩 코드는
Producer,Consumer를 사용하여 구현하였다. - 이를
CompletableFuture를 통해 리팩토링을 진행하였다.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
    public <T> void start(Generator<T> generator, long totalCount, int batchSize, Class<T> type) {
        long totalBatches = (long) Math.ceil((double) totalCount / batchSize);

        List<CompletableFuture<Void>> futures = LongStream.range(0, totalBatches)
                .mapToObj(batchIdx -> {
                    int currentBatchSize = calculateBatchSize(batchIdx, totalBatches, totalCount, batchSize);
                    return CompletableFuture
                            .supplyAsync(() -> generateBatch(generator, currentBatchSize), producerExecutor) // run async logic (in producerExecutor)
                            .thenAcceptAsync(batch -> jdbcBatchWriter.insertBatch(type, batch), consumerExecutor); // run insert async logic (in consumerExecutor)
                }).toList();

        try {
            CompletableFuture.allOf(futures.toArray(new CompletableFuture[0])).join();
        } catch (Exception e) {
            futures.forEach(future -> future.cancel(true));
            throw new  RuntimeException("Bulk persistence failed", e);
        }
    }
- CompletableFuture의
supplyAsync를 사용해서 스레드 풀인producerExecutor를 지정하고, 비동기로 로직을 처리하였다. - 이후
thenAcceptAsync를 통해supplyAsync의 결과를 다시consumerExecutor를 지정해 소비자 스레드풀에서 해당 로직을 바로 비동기 실행할 수 있도록 구현하였다. 마지막에,
join()을 사용해 모든 future가 완료될 때가지 대기할 수 있었다.- 리팩토링 전의 코드와 달라진 점은 다음과 같다.
Producer,Consumer제거 : 메서드 체이닝을 통해 구현BlockingQueue제거CountDownLatch제거 :allOf().join()사용- 예외 처리 : 실패 시
future.cancel(true)를 통해 진행 중인 작업까지 취소
원문: Velog