Spring에서 antlr 사용하기 (gradle)
antlr는 ANother Tool for Language Recognition 의 줄임말로, 일정한 규칙을 지닌 문자열을 런타임에 파싱할 수 있도록 도와주는 파서 도구(라이브러리)이다.
Spring에서 antlr 사용하기 (gradle)
antlr란?
- antlr는 ANother Tool for Language Recognition 의 줄임말로, 일정한 규칙을 지닌 문자열을 런타임에 파싱할 수 있도록 도와주는 파서 도구(라이브러리)이다.
- 자바 ORM인 Hibernate는 SQL 쿼리문을 의미있는 단위로 파싱 및 처리하기 위해 antlr를 사용하며 , 검색 엔진인 ElasticSearch또한 해당 툴을 사용한다.
- 이러한 파싱 툴로 로그·쿼리를 분석 및 파싱하여 의미있는 데이터만 추출할 수 있다.
사용 방법
antlr 라이브러리는
.g4파일을 통해 파싱 규칙을 정의한다. 미리 정의한.g4파일을 통해 gradle에서 자바코드로 문법클래스를 자동으로 생성한다. 이렇게 문법파일을 자바 클래스로 변환하여 자바 코드 레벨에서 String형태의 자료형에 문법을 적용하여 파싱을 진행할 수 있다.먼저, gradle에서 antlr플러그인 + runtime을 추가한다.
1
2
3
4
5
6
7
8
9
10
11
12
plugins {
	id 'antlr'
}

dependencies {
	  antlr "org.antlr:antlr4:4.13.1" // g4 파일을 java 코드로 변환
    implementation "org.antlr:antlr4-runtime:4.13.1" // 실행할 때 사용
}

antlr {
    arguments += ['-visitor', '-long-messages'] // Visitor & Listener 자동 생성
}
.g4파일 위치는src/main/antlr/Arithmetic.g4로 두면 된다.- 간단한 계산(더하기 곱하기)문법은 아래와 같이 표현할 수 있다.
1
2
3
4
5
6
7
8
9
10
11
grammar Arithmetic;

// Parser rules
expr : addExpr ;
addExpr : mulExpr ('+' mulExpr)* ;
mulExpr : atom ('*' atom)* ;
atom : INT  | '(' expr ')' ;

// Lexer rules
INT     : [0-9]+ ;
WS      : [ \t\r\n]+ -> skip ;
- 위 문법은 BNF와 비슷한 antlr 도메인 특화 언어 (DSL)이다. 필자도 처음에는 생소했지만, 금방 적응할 수 있었다.
문법구조
ANTLR문법은 크게 3가지 파트로 나눌 수 잇다.
- Grammar 선언
grammar {규칙이름};으로 작성한다.- 여기서 지정한 규칙이름이 곧 파일명
{규칙이름}.g4가 되어야 한다. - 위 예제에서는 해당 파일의 이름은
Arithmetic.g4이 될 것이다.
- Parser 규칙
- 문자열을 의미단위로 어떻게 쪼갤지를 정의한다.
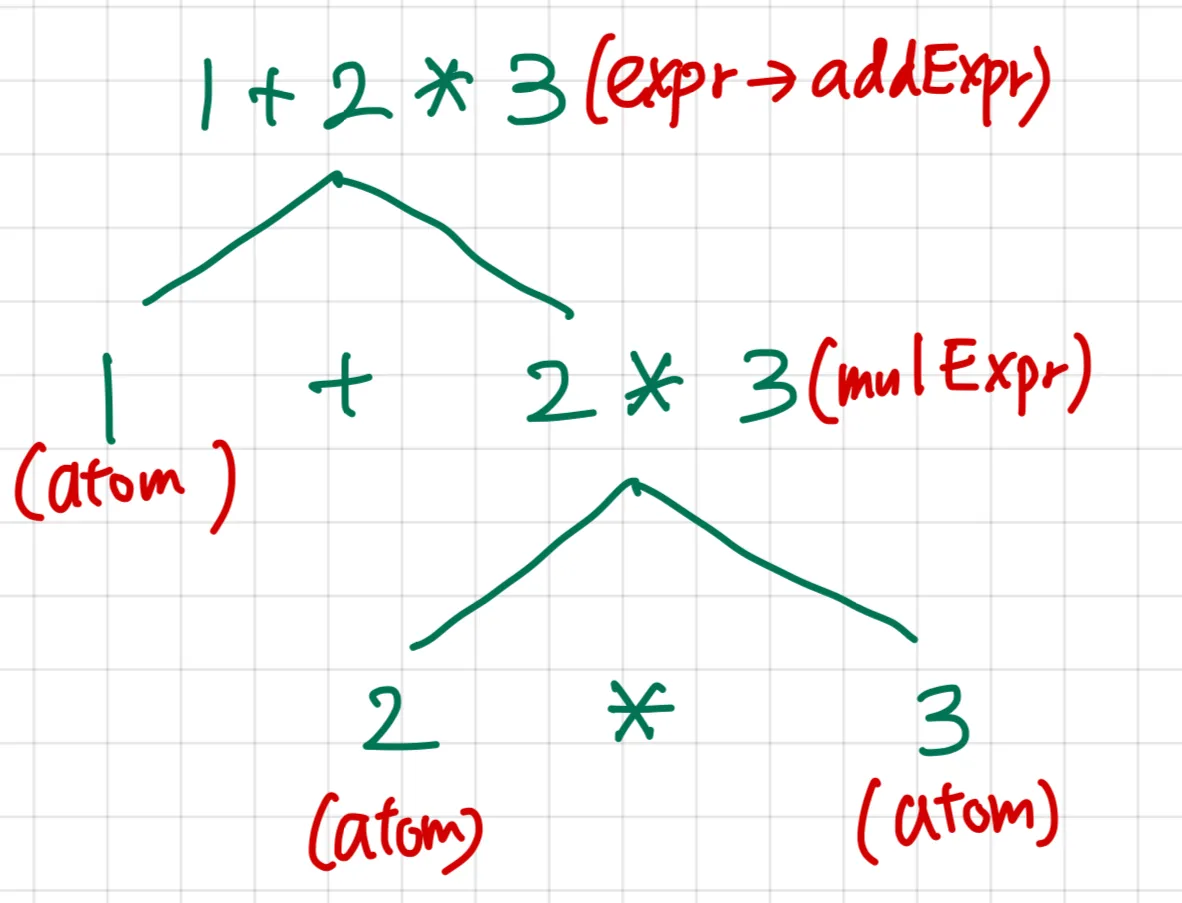
- 위 예제에서는
expr라는 의미 단위를 곱셈, 덧셈, 괄호처리를 작은 단위로 분해할 수 있도록 정의하였다.expr→addExpr→mulExpr→atom으로 진행되는 흐름을 확인할 수 있다.
- Lexer 규칙
- 기본단위(토큰)을 어떻게 인식할지를 결정한다.
- 위 예제에서, INT라는 단위는
[0-9]+로 정의되어 하나 이상의 숫자를 의미한다. - WS같은 경우에는, 공백처리를
skip을 붙여 무시하도록 설정하였다.
- 마치 spring을 사용할 때 빌드 설정을 위해 groovy라는 도메인 특화 언어로
build.gradle를 작성하는 것과 비슷하다고 생각했다. - 즉, 특정 목적(빌드 or 파싱 등..)을 위해 제공되는 도메인 특화 언어(DSL)를 사용해 규칙을 정의하는 것이다.
1
./gradlew generateGrammarSource
- 위 명령어를 통해
.g4파일을 자바 코드로 변환한다. Lexer,Parser,BaseVisitor,Visitor,Listener클래스가build/generated-src/antlr/main/경로에 생성된다.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
public class Main {
    public static void main(String[] args) {
        String input = "2+3*4";

        // 1. 문자열을 CharStream으로 변환
        CodePointCharStream stream = CharStreams.fromString(input);

        // 2. Lexer 생성
        ArithmeticLexer lexer = new ArithmeticLexer(stream);

        // 3. TokenStream 생성
        CommonTokenStream tokens = new CommonTokenStream(lexer);

        // 4. Parser 생성
        ArithmeticParser parser = new ArithmeticParser(tokens);

        // 5. 진입점(expr) 파싱 → ParseTree 얻기
        ParseTree tree = parser.expr();
        System.out.println(tree.toStringTree(parser));
    }
}
- 위 코드에서
parser.expr();를 통해ParseTree라는 것을 생성한다.ParseTree는 각 노드로 이루어지며, 각 파서를 담당하는 노드 클래스는ParserTree.{파서이름Context}로 구현되어있다. 해당 노드 클래스를 통해 토큰 값 조회, 하위 노드 접근, 상위 노드 접근, 트리 탐색 등을 수행할 수 있다. - 위 코드를 실행하면 대략 아래와 같은 파싱 결과를 확인할 수 있다. (계산기 결과 x)
1
(regex (expr (element (atom (charClass [ (classAtom a) (classAtom b) (classAtom c) ])))))
- 우리는 각각의 lexer들에 접근해서 특정 로직을 실행시켜야 의미있는 파싱이 이루어지지만, 위와같은 형태는 의미는 구분되었지만 결국 문자열을 다시 파싱해야하는 곤란한 상황이 발생한다.
BaseVisitor
- 위와같은 문제를 마주쳤을 때, gradle의 antlr플러그인으로 자동 생성한 자바 클래스 중
BaseVisitor.class로 문제를 해결할 수 있다.
1
2
3
4
5
6
7
8
9
10
public class ArithmeticBaseVisitor<T> extends AbstractParseTreeVisitor<T>
                                      implements ArithmeticVisitor<T> {
    @Override public T visitMulExpr(ArithmeticParser.MulExprContext ctx) {
        return visitChildren(ctx);
    }
    @Override public T visitAddExpr(ArithmeticParser.AddExprContext ctx) {
        return visitChildren(ctx);
    }
    ...
}
- 코드를 뜯어보면, 메서드 이름이 visit + parser이름으로 되어있다. 그리고 각각의 메서드들은
visitChildren(ctx);를 반환한다. - 이때 ArithmeticParser.Context같은 클래스는 자동 생성된 파서규칙 노드타입이다.
MulExpr라는 파서를.g4에서 선언했기에 자동생성되었다. - 클래스 이름이 Context로 끝나는 노드가 parser이름을 방문했을 때, 다음 하위의 노드(children)으로 내려간다는 의미가 되겠다.
- 즉, 특정 parser를 방문하면, 호출되는 메서드임을 알 수 있다.
- 이를 extends하고 필요한 메서드만 오버라이드하여 사용자 전용 파싱 로직을 작성할 수 있다.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
public class ArithmeticVisitorImpl extends ArithmeticBaseVisitor<Integer> {

    @Override
    public Integer visitIntExpr(ArithmeticParser.IntExprContext ctx) {
        return Integer.valueOf(ctx.INT().getText());
    }

    @Override
    public Integer visitAddExpr(ArithmeticParser.AddExprContext ctx) {
        int left = visit(ctx.expr(0));
        int right = visit(ctx.expr(1));
        return left + right;
    }

    @Override
    public Integer visitMulExpr(ArithmeticParser.MulExprContext ctx) {
        int left = visit(ctx.expr(0));
        int right = visit(ctx.expr(1));
        return left * right;
    }

    @Override
    public Integer visitParenExpr(ArithmeticParser.ParenExprContext ctx) {
        return visit(ctx.expr());
    }
}
- 위와같이 특정 parser에 접근했을 때 어떤 로직을 실행할지 정의할 수 있다.
visitAddExpr메서드에서,AddxprContext라는 노드의 첫 번째expr에 방문하면, 다시visitIntExpr메서드가 invoke되어, 해당 expr노드의 값을 리턴한다.- 각각의
expr의 값을 더해 덧셈이 구현된다. - 이렇게 각 노드별 메서드가 재귀적으로 호출되면서, 트리 전체를 탐색하고 최종 값을 계산하게 된다.
BaseListener
- 위에서 언급한
BaseVisitor는, 사용자가 트리를 탐색하는 시점(visit(ctx.expr()))을 직접 제어한다. Listener클래스는 파서가ParseTree를 생성할 때, 자동으로 콜백메서드를 호출한다.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
public class RegexBaseListener implements RegexListener {
	/**
	 * {@inheritDoc}
	 *
	 * <p>The default implementation does nothing.</p>
	 */
	@Override public void enterRegex(RegexParser.RegexContext ctx) { }
	/**
	 * {@inheritDoc}
	 *
	 * <p>The default implementation does nothing.</p>
	 */
	@Override public void exitRegex(RegexParser.RegexContext ctx) { }
	/**
	 * {@inheritDoc}
	 *
	 * <p>The default implementation does nothing.</p>
	 */
	@Override public void enterExpr(RegexParser.ExprContext ctx) { }
	/**
	 * {@inheritDoc}
	 *
	 * <p>The default implementation does nothing.</p>
	 */
	@Override public void exitExpr(RegexParser.ExprContext ctx) { }
	/**
	 * {@inheritDoc}
	 *
	 * <p>The default implementation does nothing.</p>
	 */
	@Override public void enterElement(RegexParser.ElementContext ctx) { }
	/**
	 * {@inheritDoc}
	 *
	 * <p>The default implementation does nothing.</p>
	 */
	@Override public void exitElement(RegexParser.ElementContext ctx) { }
- 위 코드와 같이, 특정 노드에 진입하거나(enter), 나갈 때(exit) 호출되는 콜백 메서드를 확인할 수 있다.
- 사용자가 직접 탐색하지 않고 파싱시에 호출된다는 점에서 실시간 이벤트 처리나 로그 처리에 사용될 수 있겠다.
원문: Velog
이 기사는 저작권자의 CC BY 4.0 라이센스를 따릅니다.