[Spring Boot] JPA 컬렉션 조회 정리
Spring Boot 프로젝트를 진행할 때마다 안다고 생각하지만 항상 막히는 부분이 있다. 바로 JPA이다.특히 컬렉션 조회에서 주의해야 할 부분을 인지하지만 머릿속에 정리가 잘 안되어있어 헷갈리는 부분이 많았다.
[Spring Boot] JPA 컬렉션 조회 정리
- 프로젝트를 진행할 때마다 안다고 생각하지만 항상 막히는 부분이 있다. 바로 JPA이다.
- 특히 컬렉션 조회에서 주의해야할 부분을 인지하지만 머릿속에 정리가 잘 안되어있어 헷갈리는 부분이 많았다.
- 이를 방지하고 만약 잊어버려도 다시 찾아볼 수 있도록 하기 위해 정리하게 되었다.
컬렉션 조회 (OneToMany & ManyToMany)
- 모든 문제의 근원이 되는 컬렉션 조회이다.
- 엔티티 관계에서 (1 : n)의 관계를 가진 연관관계를 뜻한다.
- 예를 들어 우리나라에는 여러 학교가 존재하고, 각 모든 학교는 여러 학생들이 있다.
- 해당 예시에서
우리나라 - 학교관계가 1 : n 관계가 될 수 있으며,학교 - 학생관계도 1 : n관계가 된다.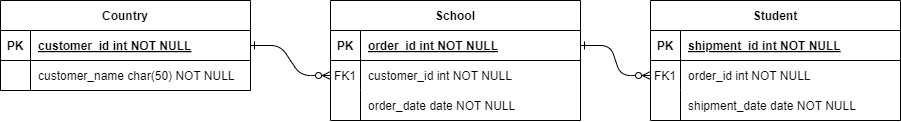
- 이를 ER 다이어그램으로 표현하면 위와 같겠다.
요구사항
- 학교 하나를 쿼리해오는 요구사항이 생겼다. 단, 해당 학교의 모든 학생 이름을 가져와야 한다고 가정하자
1
2
3
4
5
6
7
{
    "schoolId" : "1",
    "shcoolName" : "aaa",
    "studentNameList" : [
        "AAA", "BBB", "CCC", ...
    ]
}
JpaRepository의findById()메서드를 이용해 모든 학생들을 가져오자1 2 3 4 5 6 7 8 9 10 11 12 13 14 15
public SchoolDto findAllStudent() { return schoolRepository.findById(1).stream() .map(school -> { SchoolDto schoolDto = new SchoolDto(); schoolDto.setSchoolId(school.getId()); schoolDto.setSchoolNames(school.getName()); List<String> studentNames = school.getStudents().stream() .map(Student::getName()) .collect(Collectors.toList()); schoolDto.setStudentNameList(studentNames); return schoolDto; }).orElseThrow(); }
- 이런 로직으로 school객체를 schoolDto로 데이터에 맞게 변환하여 반환할 수 있다.
- 하지만 이를 실행하면 에러가 발생한다.
1
2
3
4
5
{
"success": false,
"code": "500 INTERNAL_SERVER_ERROR",
"result": "could not initialize proxy [.domain.school.entity.School#202] - no Session"
}
Proxy를 초기화 할 수 없다는 에러가 발생했다.Proxy에 초점을 맞춰보자
Proxy (EAGER or LAZY)
위 문제는 엔티티 간의 매핑 관계를
LAZY로 설정했을 때 마주하는 문제이다. `` @ManyToOne(fetch = FetchType.LAZY)기본적으로 수많은 연관관계 속에서 어느 한 엔티티를 조회했을 때, 이와 관계를 맺은 엔티티들도 조회 할 지 안 할 지에서 출발한다.
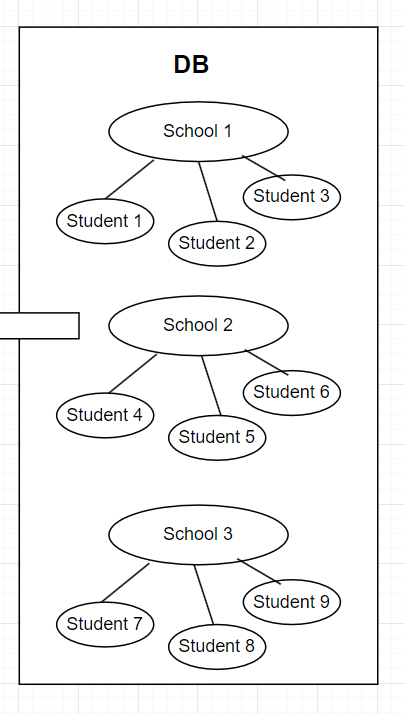
School이라는 엔티티를 조회할 때 1 : n (ToMany)관계를 갖는Student엔티티가 존재한다.
EAGER (즉시 로딩)
- 매핑 관계를
EAGER로 설정했을 경우, 해당 관계인 엔티티를 함께 조회하여 가져온다.1 2 3
@ManyToOne(fetch = FetchType.EAGER) @JoinColumn(name = "school_id", nullable = false) private School school;
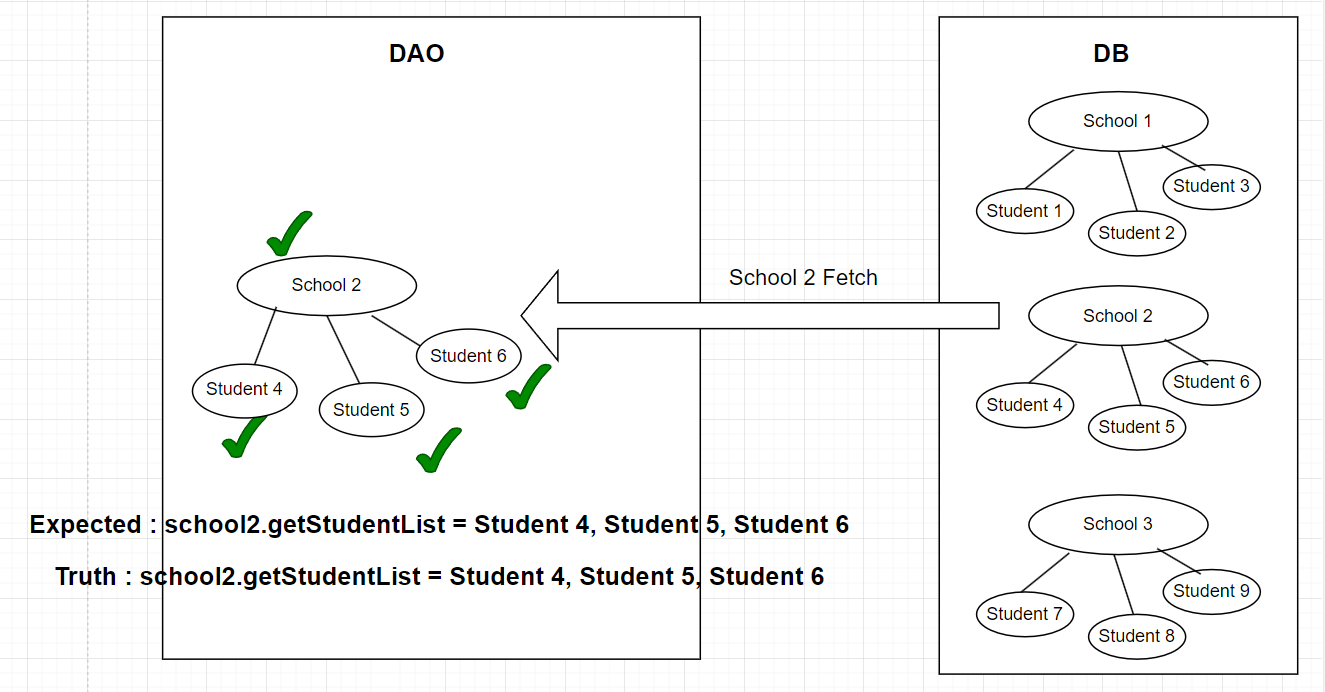
- 위 그림을 예시로,
School 2라는 데이터를 가져올 때 해당 데이터가 매핑하고있는Student엔티티의 데이터를 모두 가져온다. - 즉,
school의List<Student>값은 실제 조회한student엔티티로 초기화되어school2.getStudentList()와 같이student데이터에 접근 가능하다.
EAGER의 단점
- 연관된 모든 데이터를 한 번에 로드하여 조회하고 나면 모든 데이터에 접근 가능하다는 편리함이 존재한다.
- 하지만 연관된 데이터를 조회하기 위해 수 많은 쿼리들을 실행시킬 수 있으며,
- 하나의 엔티티의 데이터만 필요한 상황에서도 불필요한 쿼리를 실행하여 오베허드가 발생한다.
- 이를 막기 위해선 후술할 LAZY(지연로딩)을 사용하여 불필요한 데이터 로드 방지와 메모리 사용량을 효율적으로 관리해야한다.
- 앞으로의 모든 상황은
EAGER (즉시 로딩)이 아닌LAZY (지연 로딩)임을 가정한다.
LAZY (지연 로딩)
- 반면에,
LAZY는 조회하려는 엔티티만 조회한다. 해당 엔티티와LAZY매핑관계를 맺은 엔티티는 조회하지 않는다. - 대신 조회하지 않은 엔티티에 접근하는 순간에 데이터베이스를 조회한다.
1
2
3
@ManyToOne(fetch = FetchType.LAZY)
@JoinColumn(name = "school_id", nullable = false)
private School school;
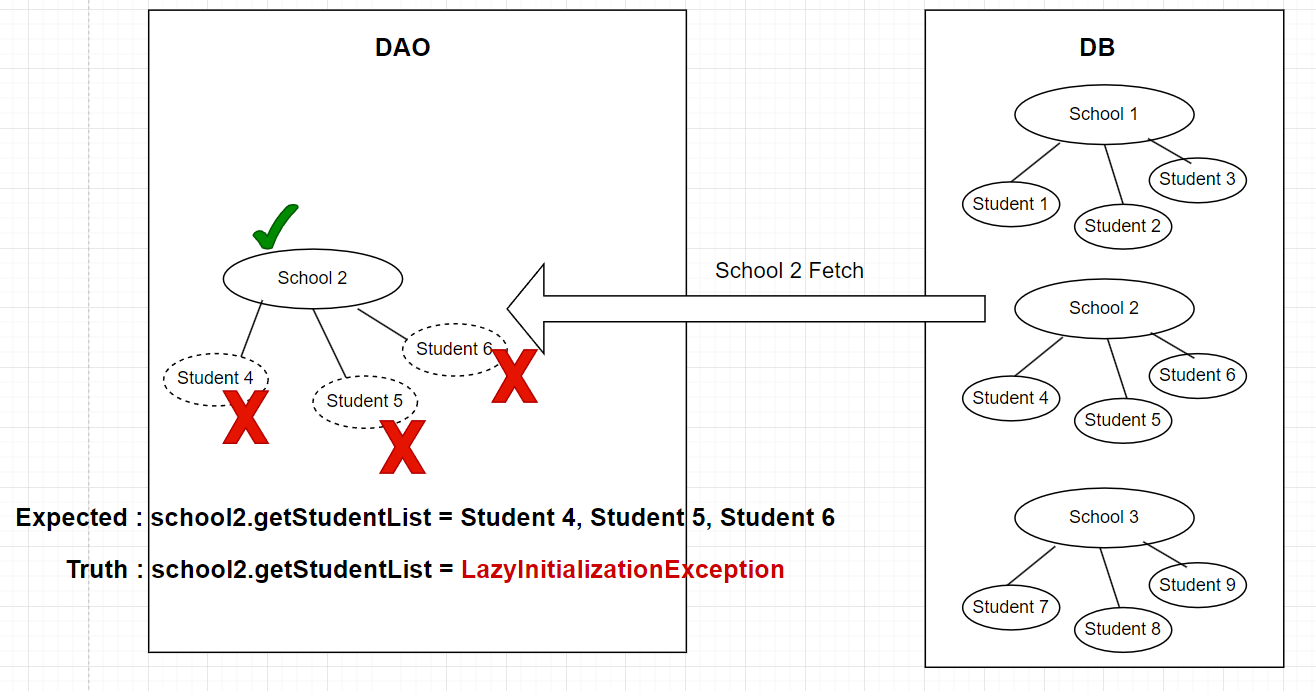
- 다음과 같이
School 2를 조회했을 시 1 : n관계를 맺는Student엔티티는 조회되지 않는다. 대신
Student엔티티는 트랜잭션 범위 내에서 조회하여 올 수 있도록Proxy객체로 초기화된다.- 하지만 조회하지 않은 엔티티에 접근하는 순간 데이터베이스에서 해당 엔티티를 조회한다고 하지 않았는가?
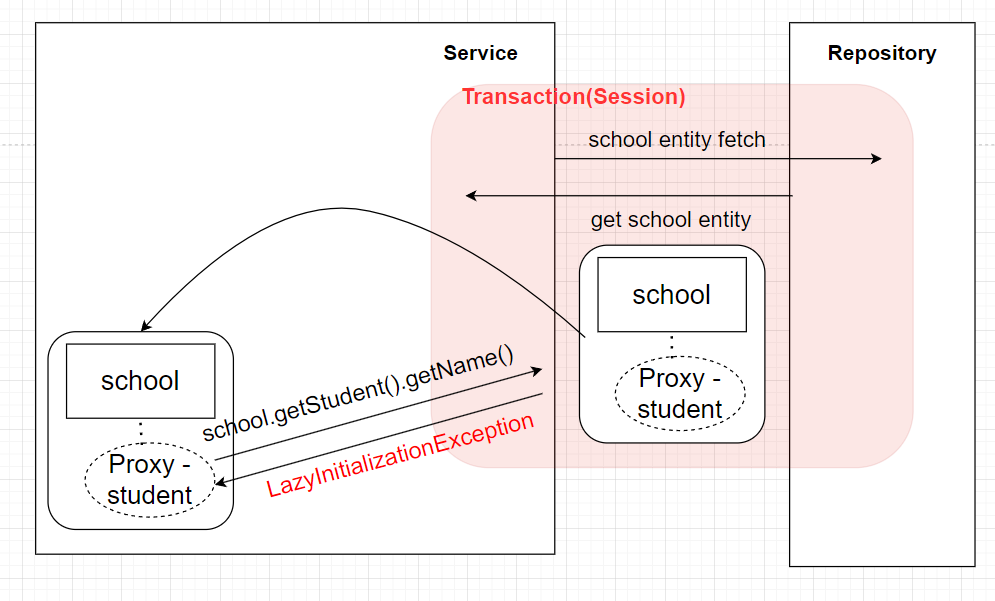
- 연관 엔티티를 조회할 수 있는 조건이 존재한다. 바로 해당 데이터 접근 시점이 트랜잭션 내부여야 한다.
- 위에서와 같이
could not initialize proxy에러가 발생한 이유는 트랜잭션 외부에서student의name필드에 접근하였기 때문이다. - 만약
hibernate세션이 닫힌 상태(트랜잭션 외부)에서 연관 데이터에 접근하려고 하면 위에서 발생한LazyInitializationException가 발생한다.
- 이 경우 크게 두 가지의 해결방법이 있다.
LazyInitializationException 해결방법
- 트랜잭션 범위 내에서 데이터를 조회
- 세션이 열린 상태에서 조회하면 문제되지 않는다.
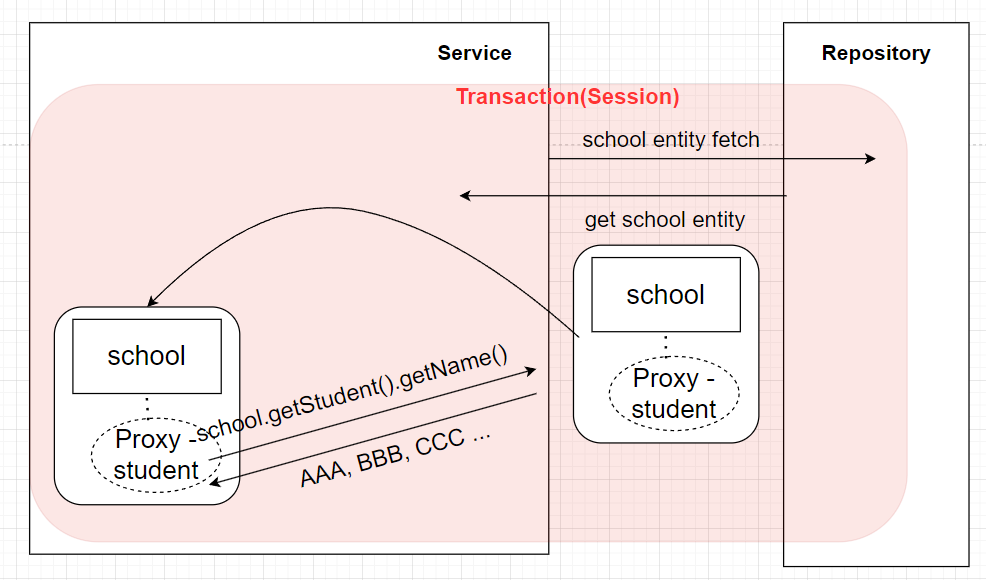
- 데이터를 접근하는 시점이
Service레이어라면, 세션이 열려있도록 해당 메서드를@Transactional로 설정한다.1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16
@Transactional(readOnly = true) public SchoolDto findAllStudent() { return schoolRepository.findById(1).stream() .map(school -> { SchoolDto schoolDto = new SchoolDto(); schoolDto.setSchoolId(school.getId()); schoolDto.setSchoolNames(school.getName()); List<String> studentNames = school.getStudents().stream() .map(Student::getName()) .collect(Collectors.toList()); schoolDto.setStudentNameList(studentNames); return schoolDto; }).orElseThrow(); }
1
2
 - 트랜잭션 범위 내에서 데이터를 로드할 수 있어 `LazyInitializationException`이 발생하지 않는다.
 - 이러한 fetch 방식과 `ToMany`연관관계에서는 후술할 N + 1문제를 일으킨다.
- 세션이 열린 상태에서 조회하면 문제되지 않는다.
fetchJoin을 사용하여 데이터를 미리 로드한다.- 트랜잭션 내부인
Repository(DAO)레이어에서 미리 데이터를 fetch하는 방법이다. - 공식
SQL문법은 아니지만JPQL쿼리에서 지원하는fetch join이라는 키워드를 사용한다.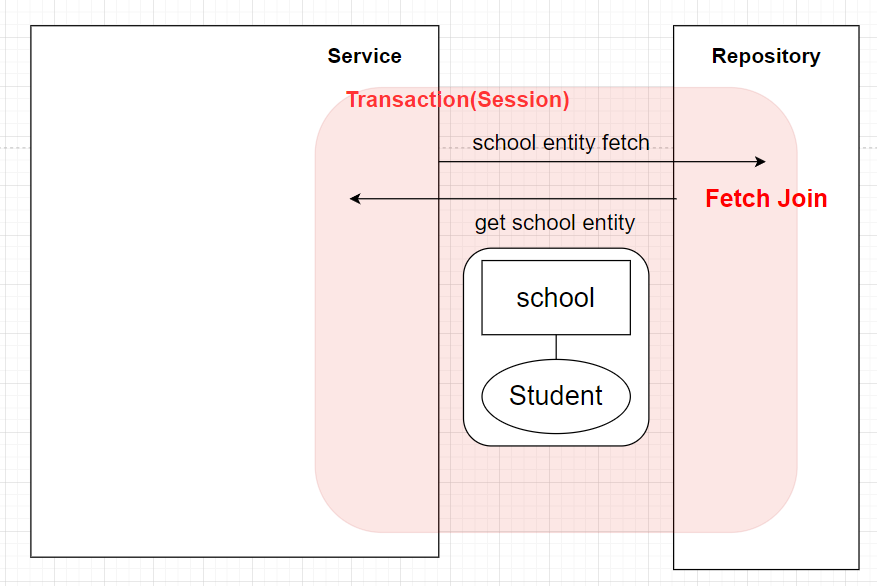
fetch join을 사용하여 작성한JPQL은 연관된 데이터들을 한 번의 쿼리로 가져온다.1 2 3 4 5
@Repository public interface SchoolRepository extends JpaRepository<School, Long> { @Query("select sc from School sc join fetch sc.student where sc.id = :schoolId") School findById(String schoolId); }
fetch join은 후술할 N + 1문제를 일으키지 않는다.
- 트랜잭션 내부인
컬렉션 조회 단점 - N + 1 문제
fetch join을 사용하지 않는 컬렉션(1: n) 조회는 N + 1 이라는 문제를 발생시킨다.- 위 상황처럼
School엔티티를 조회할 때 해당School에 속한Student의 이름을 가져와야하는 상황을 가정하자.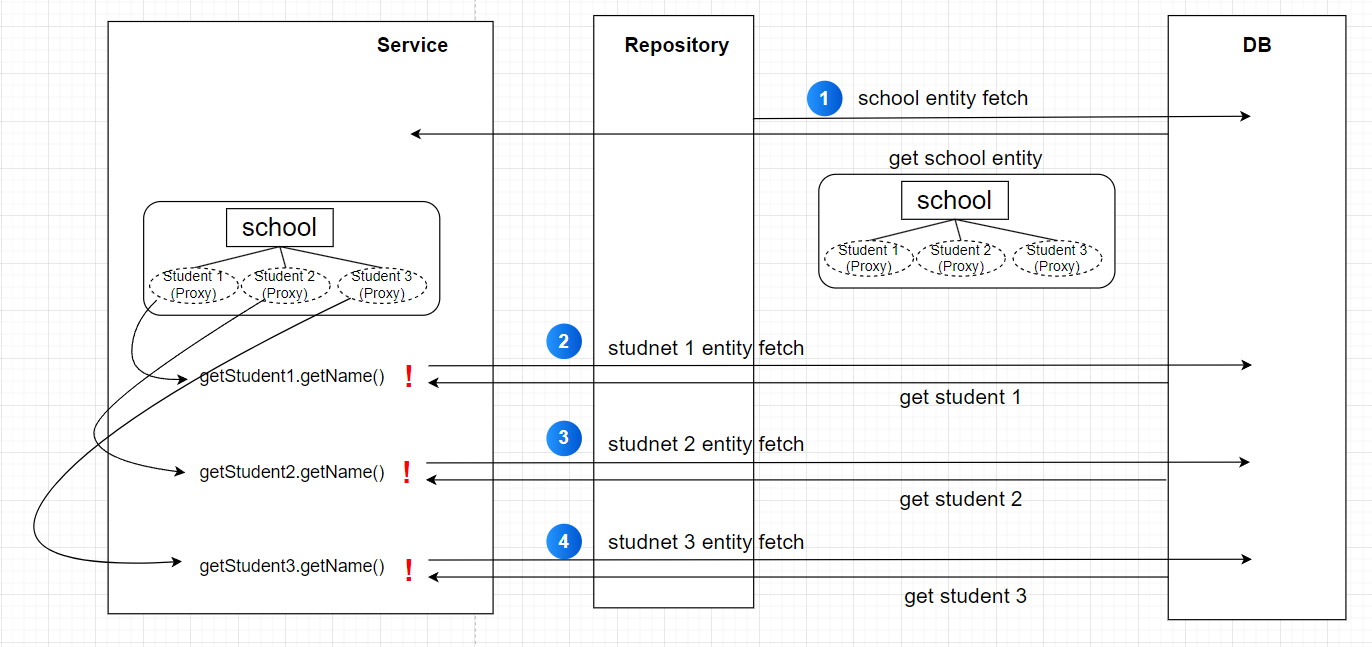
- fetch해온
school엔티티는school.getStudents()를 통해Proxy로 대체된Student엔티티를 확인할 수 있다. - 이때 모든
Student엔티티를 순회하며student.getName()메소드를 호출하는 순간Proxy가 초기화되며 데이터베이스에서 값을 조회하게 된다. - 즉,
school엔티티를 가져오는 쿼리 1번 +school엔티티와 관계를 맺는student엔티티 3개를 조회하기 위한 쿼리 3번 - 총 4 = (1 + 3)번의 쿼리가 발생하는 문제가 발생한다.
- 만약 한 학교에 학생 수가 10,000,000명이 존재할 수도 있다. 그러면 모든 학생의 이름을 조회하기 위해 총 1 + 10,000,000개의 쿼리를 실행해야하는 상황이 발생한다.
- 한 번의 쿼리를 호출했으나 부가적인 쿼리가 생기는 문제를 N + 1 문제라고 한다.
- 얼핏 보면 하나의
school를 조회하는 쿼리처럼 보일 수도 있지만 해당 엔티티가student엔티티와 1 : n 관계를 맺고 있어 자식 엔티티를 개별로 조회하여 예상치 못한 추가적인 쿼리가 발생한다. - 데이터베이스에 부하가 커져 조회시간이 기하급수적으로 증가하는 문제가 발생한다.
N + 1 문제 해결방법 - Fetch Join & Batch Size
- N + 1 문제를 해결하는 방법으로 두 가지가 있다.
Fetch Join
fetch join을 사용한다.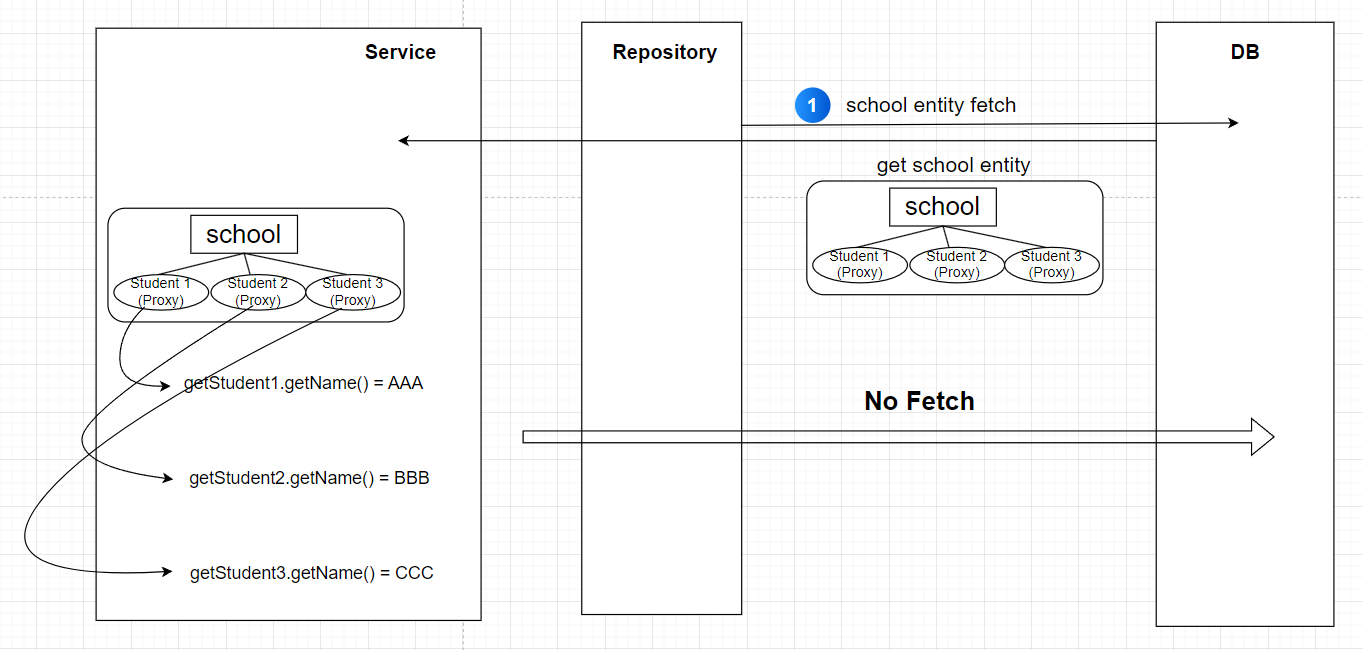
- 위에서 서술했듯이
fetch join을 사용하면 N + 1문제를 고려하지 않아도 된다. - 한 번에 쿼리(트랜잭션 내부)에서 조인을 한 모든 연관 데이터들을 fetch해오기 때문이다.
fetch join으로 한 번 fetch해오면 컬렉션 엔티티인Student들은Proxy객체가 아닌 실제 데이터가 담긴 엔티티이다.- 그러므로
Student에서 데이터에 접근할 때마다 쿼리를 날리지 않게 된다.
- 위에서 서술했듯이
Batch Size
spring.jpa.properties.hibernate.default_batch_fetch_size: n설정한다.- N + 1문제는 하나의 쿼리를 요청할 때 부가적으로 발생하는 N개의 쿼리가 문제의 원인이다.
- 해당 속성은
hibernate에서 지원하는 속성으로,application.yaml파일에서 설정 가능하다. - 연관된 엔티티를 가져오기 위한 쿼리를 한 엔티티에 한 번씩 쿼리를 보내는 것이 아닌
IN절을 사용하여 n개씩 묶어 쿼리를 보내는 방식이다.
- N + 1문제로 인해 1000개의 연관 엔티티를 조회해야 할때
default_batch_fetch_size: 100이라고 가정해보자.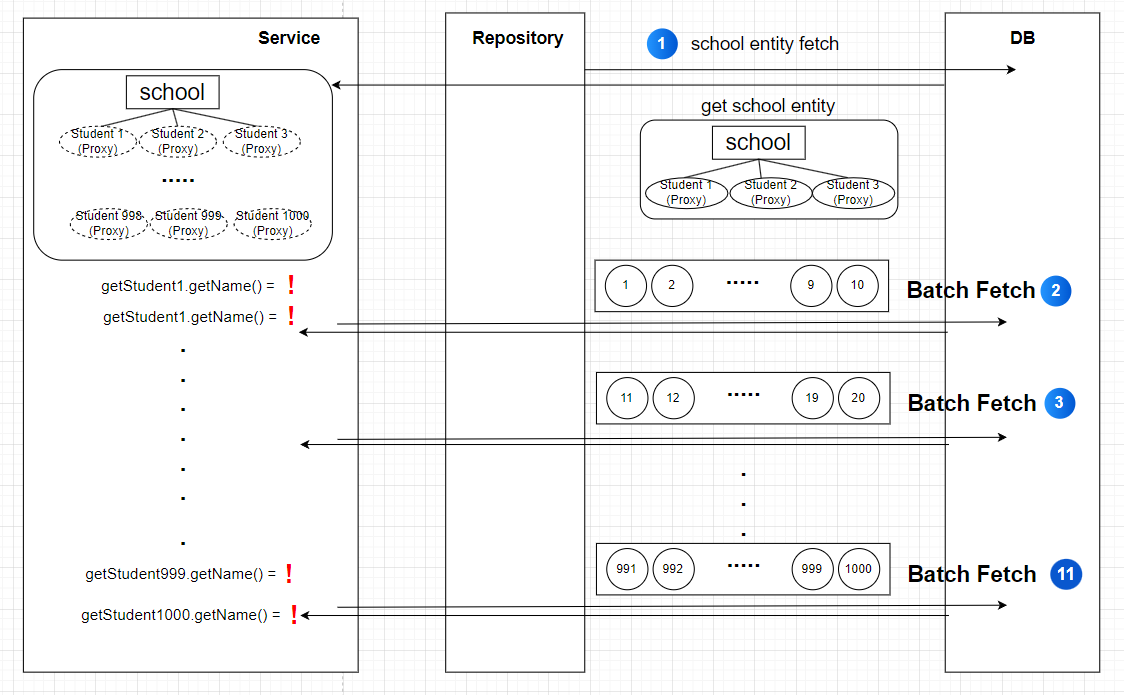
- 그림으로 표현하면 위와 같겠다.
- 먼저,
school을 fetch해온다. 해당school은 1000개의student객체를 가지고 있다. 지연로딩(LAZY)이므로student객체는Proxy로 대체된다. - 이제
school.getStudents()를 순회하며 각student.getStudents().getName()을 호출하여 엔티티 조회를 시도한다. - 이때
default_batch_fetch_size를 100으로 설정했으므로 조회 쿼리가 100개가 쌓이면 100개의 쿼리를IN절로 묶어 하나의 쿼리로 조회한다. student엔티티가 1000개라고 가정했으므로 100개씩 묶어 조회하게 되면schoolfetch 1번,studentfetch 10번으로 총 11번의 쿼리를 통해school엔티티와 1000개의student엔티티를 조회할 수 있다.- 먄약
default_batch_fetch_size를 1000으로 설정했다면,schoolfetch 1번,studentfetch 1번으로 총 2번만에 모든 연관 쿼리 조회가 가능하다.
1
2
3
4
5
6
7
8
9
[Hibernate]
    select
        s1_0.student_id,
        sl_0.name
    from
        student s1_0
    where
        s1_0.student_id in (?, ?, ?, ?, ?, ?, ?, ?, ?, ?, ?, ?, ?, ?, ?, ?, ?, ?, ?, ?, ?, ?, ?, ?, ?, ?, ?, ?, ?, ?, ?, ?, ?, ?, ?, ?, ?, ?, ?, ?, ?, ?, ?, ?, ?, ?, ?, ?, ?, ?, ?, ?, ?, ?, ?, ?, ?, ?, ?, ?, ?, ?, ?, ?, ?, ?, ?, ?, ?, ?, ?, ?, ?, ?, ?, ?, ?, ?, ?, ?, ?, ?, ?, ?, ?, ?, ?, ?, ?, ?, ?, ?, ?, ?, ?, ?, ?, ?, ?, ?)
default_batch_fetch_size를 설정했을 때 다음과 같이IN절을 사용하여 한꺼번에 select하여 데이터를 가져옴을 확인할 수 있다.Batch Size를 설정하여 지연 로딩으로 인한 추가 쿼리를 획기적으로 줄여 N + 1문제를 해결 가능하다.
Fetch Join
- 일전에 서술했던
Fetch Join에 대해 추가적으로 정리하고자 한다. Hibernate에서 연관된 데이터를 한 번의 쿼리로 가져오기 위해 사용하는 키워드이다.- SQL의 Native 문법이 아닌, JPA의 성능 최적화를 위한 문법이다.
1
2
@Query("select sc from School sc join fetch sc.student")
List<School> findAll();
fetch join을 사용한JPQL문을SQL로 변경 가능하다.
select sc.id, sc.name, s.id, s.name
from School sc
join Student s on sc.id = s.school_id;
student와school을join하여,school과student의 속성들을 모두select하여 모든 학생 정보를 가진school엔티티가 fetch된다.
원문: Velog
이 기사는 저작권자의 CC BY 4.0 라이센스를 따릅니다.